我为小说忙:(六)我们需要 OCR
严格来说,本文算是番外篇,因为插件的主体部分已经开发完毕。但光有插件肯定是不够的,我们还需要内容。对于《如果瓷杯从未冷透》来说,由于一开始就是电子版,直接复制粘贴就行,但另外一本,《触碰:晨晓之源》,这个就只有高中时候在学校里手写的纸质版了,因此需要预先转换为电子版,才能放到站上。
对于转换操作来说,最直观的就是拉个人来一边看一边打,但这效率非常低,而且很累人。所以想了想,笔者选择了第二条路:直接对这些手稿进行OCR,然后再校对。
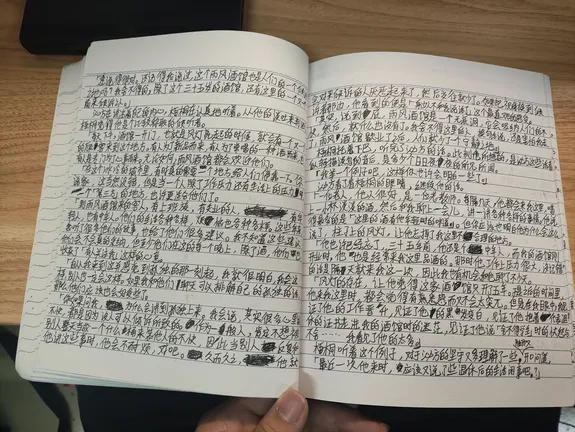 手稿原件大概就是这个样子,这还算好的了
1. 前言
手稿分散在五个笔记本上,从写出来的第一天起,就在想办法把他们录入到电脑里了。当时写的时候想着是,以后回家有空的时候就抽空打一两篇,结果到周末就没精力干了,于是日积月累,就成了目前的现状。
寄希望于OCR(光学字符识别),其实并非无稽之谈。OCR技术本身来说已经非常成熟,早在二十多年前的电脑杂志,就有在介绍扫描仪的时候提到某款扫描仪软件『自带光学字符识别功能』。当时的扫描效果如何,笔者已经无从探究,但经过这么多年的发展,想必也已经有了长足的进步。
从技术上来说,OCR的识别准确率当然是越高越好。对于字体规范的印刷稿来说,OCR一般都没有太大问题,但对于手写稿,那就有些耐人寻味了。传统的OCR技术对手写稿的识别率一直低于印刷稿很多,即使是现在,考虑到不同人的书写习惯以及字形字迹不同,更别提还有涂改等情况,所以一般不能说达到和印刷稿一样的效果。因此,其识别结果必然充满了各类错别字,空缺,换行错误等问题,在正式成为发布稿之前必须经过人工校对。
从这一点来看,要想对这些小说手稿进行录入,技术选型这边需要考虑的事情就要分为三部分:如何高效地获取手稿的图像,如何准确且快速地对图像进行识别,以及如何方便地对识别结果进行校对。今年是6202年,处理这些问题时,我们已经有了一个很好的工具:大语言模型!
2. 搭建
2.1 选型
对于最核心的OCR部分来说,支持多模态输入的LLM一般都问题不大。笔者采用的是本地部署的Qwen3.5-9B.Q4_K_M,能勉强塞进去4060的8GB显存里,多出来的部分卸载到内存就好。大模型要开启图片识别能力,需要多下载一个mmproj文件,不过这个不难,下载并配置好即可。
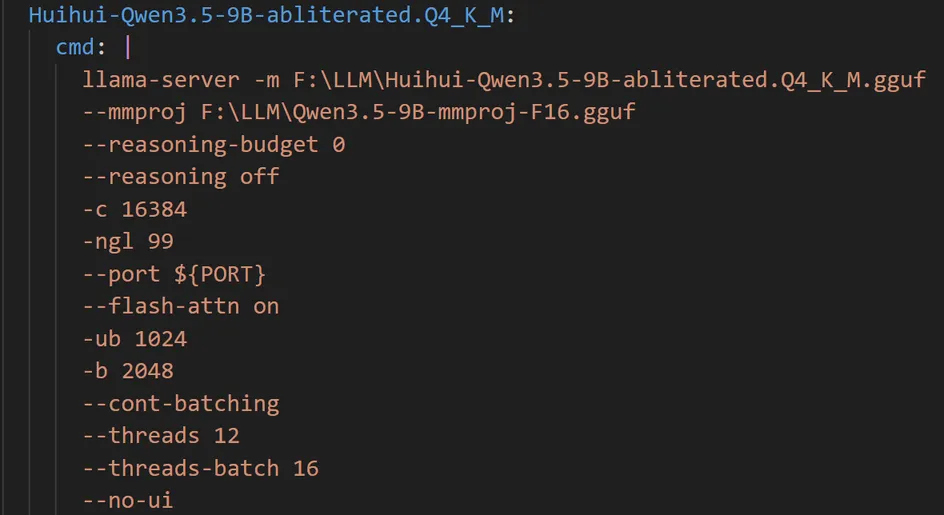 通过llama-swap运行llama-server
对于如何高效获取手稿图像,用手机批量拍照后统一上传确实是个好主意,但问题是,此时就要占用很多的手机空间,而且批量管理(包括传完之后删除)这些照片也显得比较麻烦。所以我们换个思路:依然是用手机拍照,但拍照完成后本地不保存,实时上传到电脑,交给核心进行OCR处理,不就能省下存储空间了?
更进一步地,我们也不是非要写手机APP不可,现代浏览器的JS API已经非常发达,很多以前只能C/S架构才能做到的事情,现在B/S也可以做到了。对于我们的案例来说,可以在识别器上跑一个WebUI,手机访问,js里用navigator.mediaDevices,拿到摄像头之后送给<video>实时预览,按下按钮时截取一帧上传到电脑供识别,就搞定了。
最后就是校对问题。这个反而是最好解决的,在识别器的WebUI上开一个校对页面就好。
2.2 写代码与部署
这种简单的工作,当然是懒得写了,交给大肥鱼代劳就好。
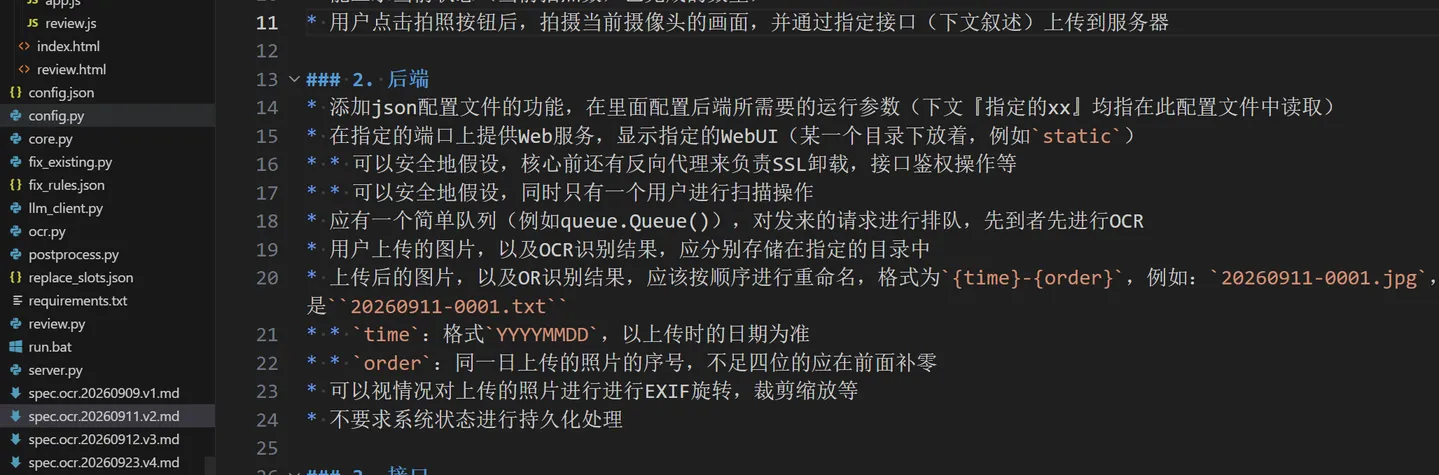 spec当然是要写好的,这个不难,反正古法编程也得捋顺思路
写这玩意的时候,大肥鱼的1017版本还未发布,用的还是0910,不过效果也很不错,一通鼓捣之后,就整出来了:
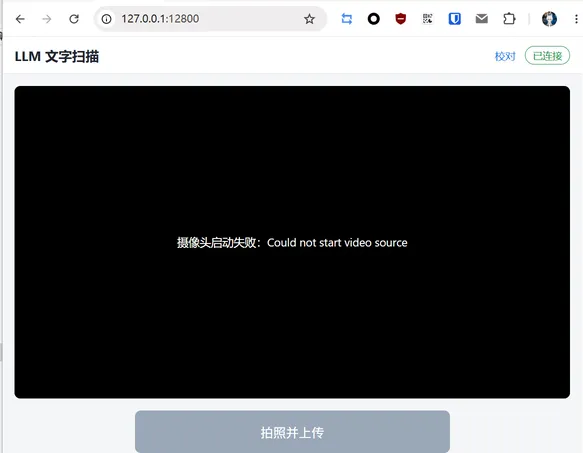 电脑端没有摄像头,黑屏是正常的
由于我们调用的媒体设备API要求安全上下文,因此前面必须要有一个HTTPS的反向代理。正巧,笔者的路由器上就有实时同步的域名证书,因此只要在路由器上用nginx做一个端口转发,就可以实现HTTPS访问了:
server {

    # 443被占用,换个端口
    listen 12800 ssl;

    ssl_certificate  /path/to/cert.crt;
    ssl_certificate_key /path/to/pri_key.key;

    server_name example.com;

    location / {
        proxy_pass http://x.x.x.x:12800;

        # 确保状态通知的SSE可以正常工作
        proxy_buffering off;
        proxy_cache off;
        chunked_transfer_encoding on;
        proxy_read_timeout 24h;
        proxy_send_timeout 24h;
        keepalive_timeout 24h;
    }
}
在手机上打开,就可以进行愉快的拍照扫描工作了。
3. 扫描
最终呈现的效果如下:
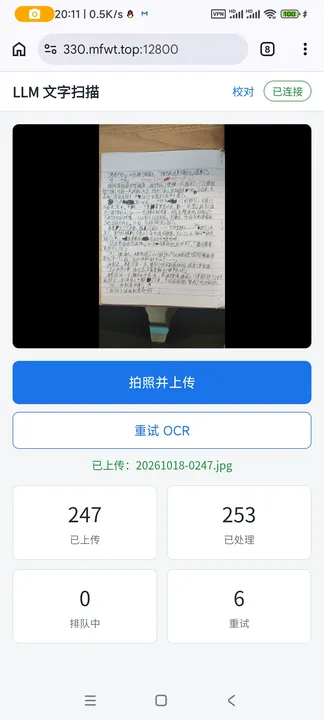
注意到页面上有一个『重试』按钮,而且下方的重试计数器也有数值。这个功能主要是为了防止LLM抽风而设计的,因为对于某些图片来说,用默认提示词和上传图片直接送入之后,得到的结果会完全崩坏,一页纸五六百字能识别出来上千个重复字符,很显然,此时就是LLM产生了幻觉,导致Token Loop,直到打爆上下文窗口(笔者只开了16K)才停下来。所以每次看到控制台不刷新进度了,显卡还在狂转,就知道肯定是又Loop了,此时就可以按一下重试,输入编号之后,核心就会将请求重新插入队列。但此时并非简单的重新尝试,而是更换另一套提示词,并预先对图片进行强化(例如二值化)操作。经过实际使用测试,这个重试的效果还是非常不错的,出现Loop现象的图片都能成功通过。
最后就是校对。这一步没什么好说的,只需要对着拍上来的图片,人工修正即可。当然为了提高便利程度,核心还设置了快捷键功能,选中需要替换的字词后,按快捷键,就可以替换为预设的字词(最主要替换的是人名),这就非常方便了。
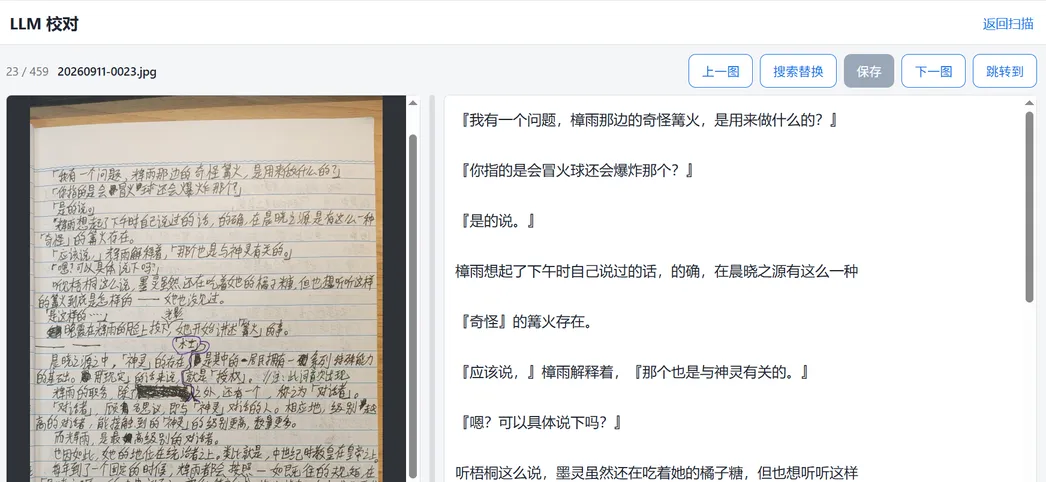 这是一份未经校对的原稿,可见总体识别率还不错,但依然无法避免错别字
4. 写在最后
五本手稿,四百多页,识别出来的原稿已经全部保存好了。
在下一步发出来之前,依然扫不了校对工作,但这已经比手打要舒服很多了。
至于接下来的日子?慢慢校对慢慢发吧。
(完)

君子善假于物也 工具越来越方便